수익화 ·
크롤링과 색인과 표준 URL을 도서관 일처럼 구분하기
먼저 답부터
크롤링은 검색 시스템이 URL을 찾아 페이지를 읽는 과정이고, 색인은 읽은 내용을 분석해 검색용 목록에 저장하는 과정입니다. 표준 URL은 비슷한 페이지 여러 개 중 대표로 삼길 바라는 주소를 알리는 신호입니다. 세 단계는 서로 다르므로 페이지 접근, 원문 내용, 선택된 대표 주소와 검색 상태를 각각 확인해야 합니다.
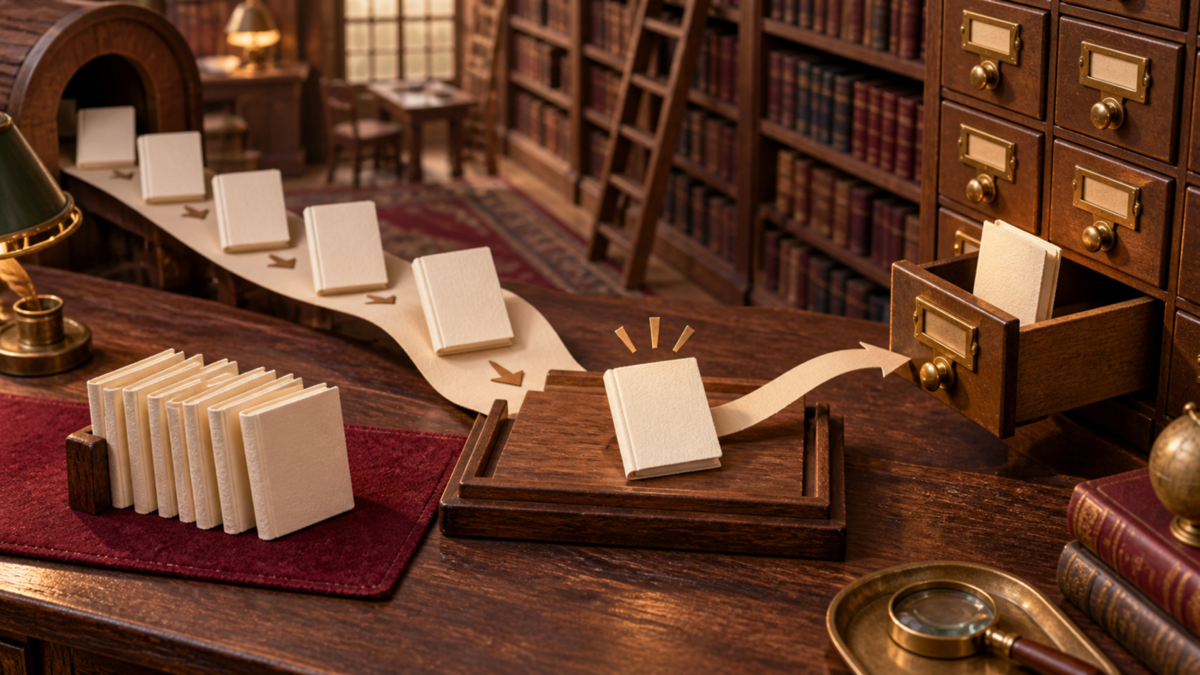
새 글 주소가 열리면 검색에도 바로 나올 것이라고 생각하기 쉽습니다. 하지만 공개 서버가 페이지를 보여 주는 일과 검색 시스템이 그 페이지를 발견하고 목록에 넣는 일은 서로 다른 단계입니다.
도서관이 새 책을 발견해 가져오고, 내용을 분류해 목록에 등록하고, 같은 책 여러 권에서 대표본을 고르는 과정처럼 보면 흐름이 선명해집니다. 어느 단계가 끝났는지 확인해야 잘못된 해결책을 피할 수 있습니다.
크롤링은 검색 시스템이 페이지를 찾아 읽는 과정이다
크롤링은 crawling, 즉 검색 시스템의 자동 프로그램이 URL을 발견하고 내용을 가져오는 과정입니다. 링크와 사이트맵에서 새 주소를 찾을 수 있지만 모든 URL을 즉시 방문하거나 항상 다시 읽는다고 보장되지는 않습니다.
페이지가 로그인 뒤에만 보이거나 서버가 오류를 돌려주거나 robots.txt에서 방문을 막으면 읽기 어려워집니다. JavaScript를 실행해야만 핵심 본문이 나타나는 페이지도 원문 HTML과 렌더 결과를 따로 확인하는 편이 안전합니다.
<meta name="robots" content="index,follow">
<link rel="canonical" href="https://www.example.com/study/web-basics">
이 코드는 색인을 허용하고 선호하는 대표 주소를 알리는 예시입니다. 태그가 있다는 사실만으로 크롤링이나 색인이 끝난 것은 아닙니다.
색인은 읽은 내용을 검색용 목록에 등록하는 과정이다
색인은 indexing, 즉 가져온 페이지의 글, 이미지, 제목과 신호를 분석해 검색에 사용할 목록에 저장하는 과정입니다. Google은 크롤링한 모든 페이지가 반드시 색인되는 것은 아니라고 설명합니다. 내용의 품질, 접근 상태, 중복 여부 등 여러 사정이 영향을 줄 수 있습니다.
따라서 URL 요청 도구에서 읽기 성공이 보여도 일반 검색 결과에 바로 나올 수 있다고 단정하지 않습니다. 반대로 검색 결과가 늦다고 서버가 닫혔다고 단정하지도 않습니다. 공개 URL의 응답, 검색 도구의 상태, 실제 검색 노출은 각각 다른 증거입니다.
표준 URL은 중복본 가운데 선호하는 대표 주소다
표준 URL은 canonical URL, 즉 같거나 매우 비슷한 내용의 여러 주소 가운데 대표로 삼길 바라는 주소입니다. 예를 들어 쿼리 문자열이 붙은 주소, HTTP와 HTTPS, www 유무 때문에 같은 본문이 여러 URL로 열릴 수 있습니다.
rel="canonical"은 검색 시스템에 선호를 알리는 강한 신호지만 절대 명령은 아닙니다. Google은 리디렉션, 사이트맵, HTTPS, 페이지 내용 같은 신호를 함께 보고 다른 대표를 선택할 수도 있다고 안내합니다. 대표 주소와 실제 내부 링크, 사이트맵 주소를 일치시키는 이유입니다.
사이트맵과 내부 링크는 발견과 일관성을 돕는다
사이트맵은 공개하고 싶은 URL 목록을 검색 시스템에 제공하는 파일입니다. 삭제된 주소나 임시 주소를 무조건 넣기보다 실제로 200 응답을 주고 색인을 허용하며 표준 URL과 같은 주소를 넣습니다. 수정일은 내용이 실제로 바뀐 날짜를 기록합니다.
- 글 상세에서 자기 자신을 가리키는 canonical을 확인합니다.
- 메뉴와 관련 글 링크가 같은 주소 형식을 쓰는지 봅니다.
- 사이트맵의 URL이 공개 페이지와 정확히 일치하는지 봅니다.
- robots 메타와 robots.txt가 서로 모순되지 않는지 봅니다.
- 제목과 H1과 본문이 주소가 약속한 질문에 답하는지 읽습니다.
- 삭제된 URL은 리디렉션이나 상태 코드를 의도에 맞게 정합니다.
알림 접수와 색인 완료를 같은 말로 쓰지 않는다
사이트맵 제출이나 변경 알림의 성공 응답은 요청이 접수됐다는 뜻입니다. 검색 결과 등록 완료를 보장하지 않습니다. Search Console 같은 관리 도구가 제공하는 URL 검사와 사이트맵 처리 상태도 시차가 있을 수 있어 검사 시각을 함께 남깁니다.
검색 순위를 높이겠다는 낯선 스크립트, 대량 URL 생성, 자동 클릭 명령은 실행하지 마세요. 검색 계정 소유권 토큰과 API 키를 문서나 공개 저장소에 넣지 않습니다. 기존 URL을 지우거나 대량 리디렉션하기 전에는 유입, 외부 링크, 복구 경로를 확인해야 합니다.
특히 “발견됨”, “크롤링됨”, “색인됨”, “대표 URL로 선택됨”, “검색 결과에 노출됨”을 한 줄의 완료 상태로 합치지 않습니다. 검사 도구의 문구와 확인 시각을 그대로 기록하면 다음 점검에서 실제로 어느 단계가 바뀌었는지 비교할 수 있습니다.
오늘 바로 해볼 작은 실습
내 사이트나 공개 예제 페이지 한 곳을 읽기만 합니다.
- 브라우저에서 페이지가 로그인 없이 열리는지 확인합니다.
- 페이지 소스에서 title과 robots와 canonical을 찾습니다.
- 화면 H1과 canonical 주소가 같은 주제를 가리키는지 봅니다.
- 사이트맵에서 정확히 같은 URL을 찾습니다.
- www, HTTPS, 끝 슬래시 형식이 섞였는지 적습니다.
- 확인 결과를 공개, 크롤링 가능, 색인 확인 세 칸으로 나눕니다.
마지막 칸은 실제 검색 관리 도구에서 확인하지 않았다면 “확인 안 됨”으로 남깁니다. 모르는 상태를 빈칸으로 두는 것이 추측으로 색인 완료를 쓰는 것보다 정확합니다.
확인한 자료
- In-depth guide to how Google Search works — Google Search Central
- What is URL canonicalization — Google Search Central
함께 읽기
- 페이지뷰와 완료 이벤트로 제품의 쓸모를 구분하는 법
페이지뷰는 페이지가 열린 횟수를 알려 주지만 사용자가 목적을 끝냈는지는 말해 주지 않습니다. 이벤트는 검색, 저장, 가입 완료처럼 의미 있는 행동이 일어난 순간을 이름과 필요한 정보로 기록합니다. 시작과 완료와 실패를 같은 흐름에서 확인해야 유입 증가와 제품 가치 증가를 구분할 수 있습니다.
- 광고와 구독과 한 번 결제를 작은 가게처럼 비교하는 법
광고는 이용자의 주의를 광고주에게 연결해 수익을 얻고, 구독은 가치가 반복되는 동안 정기 결제를 받으며, 1회 결제는 한 번 완성되는 결과에 값을 받는 방식입니다. 인기만 보고 고르지 말고 사용자가 가치를 얻는 빈도, 서비스의 반복 비용, 가격과 해지·환불을 분명히 설명할 수 있는지를 함께 비교해야 합니다.
- 결제 완료 화면과 웹훅과 환불 상태를 따로 확인하는 법
결제 성공 화면은 사용자의 브라우저가 특정 주소에 도착했다는 표시일 뿐 최종 결제 증거가 아닙니다. 서버는 결제 제공사의 상태와 서명된 웹훅을 확인해 주문을 처리하고 같은 사건을 중복 반영하지 않아야 합니다. 환불도 요청, 처리 중, 성공, 실패 상태를 나누고 실제 완료를 확인해야 합니다.